Чи знайоме вам відчуття, коли ви просите інструмент штучного інтелекту (ШІ) проаналізувати об’ємний юридичний договір на 100 сторінок або величезний репозиторій складного коду, а він просто… нічого не робить? Або, можливо, спочатку він починає відповідати, але згодом «зависає» чи взагалі дає збій?
Складається враження, що ШІ важко думає, але насправді йому важко пригадувати. І справа не в нестачі обчислювальної потужності — проблема полягає у прихованому «вузькому місці» пам’яті, яке може створювати для компаній додаткові витрати.
Причиною цього «вузького місця» є кеш «ключ-значення» (KV Cache) — своєрідна короткочасна пам’ять ШІ. Саме про цю технологію йтиметься далі.
Під час виконання інференсу на великих мовних моделях (LLM) кеш «ключ-значення» є одним із ключових механізмів підвищення ефективності. В архітектурі NVIDIA Transformer* він зберігає історичну інформацію про «обчислення уваги», що дає змогу уникати повторного виконання тих самих операцій.
Однак зі збільшенням довжини контексту обсяг пам’яті графічних прискорювачів (GPU), який займає KV-кеш, стрімко зростає, створюючи ресурсне «вузьке місце».
Для розв’язання цієї проблеми в галузі була розроблена технологія KV Cache Offload, яка переносить частину кешу до зовнішнього сховища, оптимізуючи таким чином використання пам’яті. Це дає змогу знизити навантаження на відеопам’ять і водночас зберегти високу продуктивність інференсу.
*Архітектура Transformer — це нейронна мережа, яка вивчає контекст і, відповідно, значення, відстежуючи взаємозв’язки в послідовних даних, наприклад між словами в цьому реченні. Моделі Transformer використовують набір математичних методів, що постійно розвивається та має назву «увага» (attention) або «самоувага» (self-attention), щоб виявляти складні взаємозв’язки, завдяки яким навіть віддалені елементи даних у послідовності можуть впливати один на одного та залежати один від одного.*
Що таке KV-кеш?
KV-кеш — це технологія прискорення, яка значно підвищує швидкість та ефективність генерації тексту завдяки збереженню важливої інформації з попередніх етапів і повторному використанню вже обчислених результатів. Це дає змогу уникнути повторних обчислень на кожному новому кроці.
Якщо порівняти велику мовну модель (LLM) із письменником, то Transformer — це її «спосіб мислення». Коли письменник створює розповідь, він враховує попередній зміст і вирішує, що писати далі. Так само під час генерації тексту Transformer звертається до раніше згенерованих токенів і прогнозує наступний токен.
Розглянемо простий приклад. У механізмі самоуваги Transformer кожен токен генерує три вектори:
Q (Query, запит): Яку інформацію я шукаю?
K (Key, ключ): Хто я? (координати ознак)
V (Value, значення): Який зміст я несу? (вміст ознак)
Коли Transformer генерує текст, за один раз він створює лише один новий токен. Потім модель порівнює Q цього токена з K усіх попередніх токенів, щоб визначити взаємозв’язки, а далі використовує відповідні значення V для обчислення вихідного результату.
Однак під час інференсу стандартний Transformer генерує дані токен за токеном. Наприклад:
Вхідні дані: «Я хочу прочитати»
Генерує: «Я хочу прочитати книгу»
Продовжує генерувати: «Я хочу прочитати книгу…»
Але під час генерації наступного токена модель знову обчислює K і V для всіх попередніх токенів, навіть якщо ці дані вже були розраховані раніше. Такі повторні обчислення призводять до того, що обчислювальна складність інференсу зростає квадратично зі збільшенням кількості токенів, що суттєво уповільнює процес.
Основний принцип KV-кешу полягає в тому, щоб уникнути дублювання обчислень. Його ключова ідея — безпосередньо зберігати результати попередніх обчислень K і V, усуваючи необхідність щоразу розраховувати їх заново.
Таким чином, під час генерації кожного нового токена потрібно обчислити лише значення K і V для нього, додати їх до вже кешованих результатів, а потім використати накопичений кеш для генерації наступного токена. Це знижує обчислювальну складність інференсу з квадратичної до лінійної та суттєво прискорює процес.
Чому кеш «ключ-значення» (KV-кеш) важливий для архітектури Transformer?
У великих мовних моделях (LLM) кеш «ключ-значення» став одним із ключових механізмів, що забезпечують ефективну роботу архітектури Transformer. Він не лише розв’язує проблему надлишкових обчислень, спричинених довгими контекстами, а й безпосередньо допомагає контролювати затримку та підвищувати пропускну здатність.
Його важливість насамперед проявляється в таких аспектах:
- Зниження обчислювальних витрат: усунення повторних обчислень механізму уваги (attention) для попередніх послідовностей знижує складність інференсу з квадратичної до приблизно лінійної.
- Підвищення швидкості інференсу: KV-кеш суттєво скорочує затримку під час генерації довгих текстів, покращуючи користувацький досвід.
- Підвищення ефективності використання ресурсів: скорочує непотрібне споживання пам’яті та обчислювальних ресурсів GPU, створюючи додаткові можливості для оптимізації пам’яті.
- Підтримка масштабованості та оптимізації: KV-кеш створює основу для таких рішень, як KV Cache Offload, що дають змогу переносити частину кешу до оперативної пам’яті сервера або зовнішнього сховища, знижуючи навантаження на пам’ять GPU та водночас зберігаючи високу продуктивність.

Про незалежне тестування та його результати з використанням KV-кешу та без нього можна прочитати тут: https://huggingface.co/blog/kv-cache
Що таке KV Cache Offload і для чого він потрібен?
Хоча KV-кеш прискорює інференс моделей Transformer, він має і побічний ефект — споживає значний обсяг графічної пам’яті GPU. Ця проблема стає дедалі актуальнішою зі збільшенням довжини контексту великих мовних моделей.
Наприклад, коли довжина контексту сягає 80 000 токенів, для кожного токена необхідно зберігати відповідні ключ і значення. Лише KV-кеш у такому разі може займати десятки гігабайтів графічної пам’яті.
Важливо зазначити, що пам’ять GPU має вміщувати не лише KV-кеш, а й ваги моделі, а також проміжні результати обчислень. Щойно доступна графічна пам’ять вичерпується, процес інференсу може працювати нестабільно або взагалі завершитися з помилкою.

Для розв’язання цієї проблеми в галузі й була запропонована технологія KV Cache Offload. Її основна ідея полягає в перенесенні неактивних або тимчасово невикористовуваних KV-даних із пам’яті графічного процесора на інші типи носіїв, зокрема:
- Оперативна пам’ять: має велику місткість і добре підходить для зберігання об’ємних кешів, однак характеризується нижчою пропускною здатністю та вищою затримкою порівняно з пам’яттю GPU.
- Пам’ять із високою пропускною здатністю (HBM): за швидкістю наближається до пам’яті графічного процесора, але є дорогою та має обмежений обсяг.
- SSD-накопичувачі (СГД): забезпечують дуже велику місткість зберігання, але працюють повільніше й зазвичай використовуються як додаткове рішення в особливо ресурсоємних сценаріях.
Читайте також:
https://lantec.ua/news/ai-fabryka-pid-kliuch-iak-hpe-private-cloud-ai-pryskoriuie-vprovadzhennia-innovatsii
Така технологія звільняє пам’ять графічного процесора, даючи змогу забезпечити пріоритетну та безперебійну роботу поточного інференсу. За потреби система повертає відповідні дані «ключ-значення» із зовнішнього сховища назад у пам’ять GPU.
Хоча це супроводжується певними накладними витратами на передавання даних, про які йтиметься далі, у великомасштабних сценаріях інференсу KV Cache Offload має критичне значення, оскільки дає змогу уникати збоїв і переривань, спричинених вичерпанням пам’яті.
По суті, це стратегія оптимізації пам’яті, яка допомагає досягти оптимального балансу між продуктивністю та ефективністю використання ресурсів.
Розв’язання проблеми
Щоб правильно реалізувати цю архітектуру, необхідно мати не лише сертифіковане серверне обладнання, а й коректно підібраний програмний стек, який ефективно працюватиме з апаратною частиною.
LMCache — це фреймворк із відкритим вихідним кодом, нещодавно включений до складу PyTorch Foundation, який на програмному рівні усуває описане вище «вузьке місце» завдяки багаторівневій архітектурі пам’яті. Він дає змогу зберігати кеш «ключ-значення» (KV-кеш) у зовнішньому сховищі та за потреби отримувати його для повторного використання в різних запитах і на різних прискорювачах.
LMCache дає змогу графічним процесорам (GPU) зосередитися на своїй основній задачі — обробці запитів, а не на виконанні надлишкових обчислень «ключ-значення». Зовнішнє сховище фактично виконує роль практично необмеженого пулу KV-кешу.
Така універсальність робить LMCache важливим компонентом сучасного AI-стеку, що дає змогу масштабовано обслуговувати мільйони токенів у популярних фреймворках інференсу, таких як vLLM, SGLang, llm-d тощо.
Однак перенесення цих функцій до зовнішньої підсистеми має сенс лише за умови, що система зберігання KV-кешу здатна швидко та стабільно повертати збережений контекст із високою пропускною здатністю. Тобто швидкість отримання даних має бути суттєво вищою, ніж час, необхідний GPU для повторного обчислення тензорів із нуля.

Як серверне обладнання, наприклад, можуть використовуватися сервери HPE ProLiant із відеоприскорювачами NVIDIA RTX PRO 6000 або RTX PRO 4500 Blackwell Server Edition.
Як систему зберігання даних може використовуватися HPE Alletra Storage MP X10000 — програмно-визначена масштабована система корпоративного рівня з інтегрованими інтелектуальними функціями обробки даних і централізованим рівнем зберігання для постійного спільного кешу «ключ-значення» (KV-кешу).
Завдяки поєднанню автоматизованих сервісів збагачення метаданих, високопродуктивного об’єктного сховища на базі флеш-накопичувачів, великої місткості та оптимізованого керування система забезпечує швидше реагування на ресурсоємні робочі навантаження штучного інтелекту.
Мережева інфраструктура з підтримкою RDMA може бути побудована на комутаторах NVIDIA Spectrum-X, мережевих адаптерах ConnectX та BlueField DPU, що забезпечує прямий обмін даними з низькою затримкою.

Технологія передавання даних RDMA є альтернативною архітектурою для розподіленого інференсу. Вона забезпечує пряме передавання даних між оперативною пам’яттю двох пристроїв, оминаючи центральний процесор, кеш і операційну систему.
Такий зв’язок із низькою затримкою, що обходить традиційні шляхи передавання даних через центральний процесор, знижує навантаження на сервер і прискорює переміщення даних між серверами, графічними процесорами та спільним сховищем. На наведеній вище схемі показано, як обмін даними між серверами за допомогою RDMA та GPUDirect дає змогу скоротити кількість етапів передавання даних удвічі.
Читайте також:
https://lantec.ua/news/hpe-alletra-storage-mp-x10000-otrymav-sertyfikatsiiu-nvidia-dlia-ai-navantazhen
Перехід від локального кешу сервера до постійного спільного кешу забезпечує такі експлуатаційні переваги:
- попередньо збережені в кеші префікси можна повторно використовувати в різних запитах і на різних серверах, що дає змогу скоротити надлишкові обчислення за високих навантажень;
- кеш зберігається під час перезапуску серверів і міграції робочих навантажень, що забезпечує підтримку тривалих аналітичних процесів і багаторазової взаємодії з великими документами;
- кілька серверів vLLM можуть використовувати спільний пул кешу, що підвищує загальний рівень використання ресурсів кластера.
Така архітектура теоретично дає змогу практично необмежено масштабувати обсяг кешу в корпоративних середовищах зберігання даних.
Тестування
Теорія — це завжди добре, але практичні результати мають значно більшу вагу. Так, компанії HPE та Kamiwazaпровели тестування системи зберігання даних HPE Alletra Storage MP X10000 як цільової платформи для обслуговування розподіленого KV-кешу.
Тестування було спрямоване на оцінювання впливу використання високошвидкісного сховища для зберігання KV-даних, а також на вимірювання зміни швидкості генерації вихідних токенів і часу до отримання першого токена (Time to First Token, TTFT).
Для реалістичного моделювання впливу використання системи X10000 для розвантаження KV-кешу були запущені реальні робочі навантаження із застосуванням AI-агентів.
Результати продемонстрували суттєве підвищення ефективності використання графічних процесорів (GPU):
- скорочення часу до появи першого токена (TTFT) — до 21,5 раза порівняно зі сценарієм без використання KV-кешу*;
- збільшення швидкості генерації вихідних токенів — до 19,4 раза порівняно зі сценарієм без KV-кешу;
- порівняно з розвантаженням KV-кешу лише в оперативну пам’ять переваги включали скорочення TTFT у 5,6 раза та збільшення швидкості генерації токенів у 5,9 раза.
*Наведені результати зосереджені на відносному прирості продуктивності, оскільки фактична швидкість генерації токенів і показник TTFT значною мірою залежать від конкретних запитів, використовуваної LLM-моделі та типу графічного процесора.
Сам звіт і методику тестування можна переглянути за посиланням:
https://signal65.com/wp-content/uploads/2026/03/Signal65-Insights_Maximizing-GPU-Utilization-with-HPE-Alletra-Storage-MP-X10000.pdf
Значення для бізнесу
Для керівників, відповідальних за інфраструктуру, висновок очевидний: постійний кеш «ключ-значення» з підтримкою RDMA діє як архітектурний мультиплікатор інвестицій у графічні процесори.
Замість того щоб вирішувати проблеми затримки та пропускної здатності виключно за рахунок додаткових потужностей графічних процесорів, організації можуть суттєво підвищити ефективну продуктивність наявної інфраструктури.
Результатом такої архітектури є скорочення надлишкового попереднього заповнення, зниження часу від запиту до відповіді (TTFT) в умовах паралелізму, покращення збереження кешу під час різних інфраструктурних подій і підвищення ефективного завантаження графічних процесорів.
Такий рівень підвищення продуктивності означає збільшення кількості користувачів у 10–15 разів за використання того самого кластера, можливість виділення бюджету на додаткові моделі або сценарії застосування, а також різницю між пілотними проєктами у сфері ШІ та комерційно готовими системами.
Цей підхід однаковою мірою застосовний до сценаріїв використання з інтенсивною обробкою документів, таких як діалоговий пошук, перевірка нормативних документів і міські інформаційні помічники, де повторювана взаємодія зі спільними наборами даних безпосередньо виграє від використання постійного спільного кешу.
За рахунок скорочення надлишкового попереднього заповнення та покращення повторного використання кешу між вузлами підприємства можуть створювати більш чутливі системи ШІ, максимально ефективно використовуючи наявні в їхньому розпорядженні ресурси графічних процесорів.
Висновок
Оскільки робочі навантаження, пов’язані з інференсом, стають дедалі важливішою частиною впроваджень LLM, використання KV-кешу має значний вплив на продуктивність та економічну ефективність інференсу. Додавання системи зберігання HPE Alletra Storage MP X10000 як вторинного KV-кешу забезпечило більш ніж п’ятикратне підвищення продуктивності незалежно від того, чи вимірювалася вона за показником TTFT, чи за швидкістю генерації токенів. Очевидно, що компанії, які використовують масштабований вторинний KV-кеш, отримають значну перевагу в продуктивності та фінансовій ефективності порівняно з тими, хто його не використовує.
Можна сказати, що HPE Alletra Storage MP X10000 перетворює сховище на справжнє розширення пам’яті графічного процесора, забезпечуючи довші контекстні вікна, швидші обчислення та ефективнішу роботу великомасштабних систем ШІ без типових обмежень графічної пам’яті. Ваша система ШІ більше не матиме труднощів із запам’ятовуванням даних — вона нарешті зможе працювати так, як і було задумано.
Компанія LANTEC спільно з HPE вже реалізувала проєкт із використанням цієї архітектури, підвищивши при цьому швидкість генерації інференсу.
Продовження «Казки про Королівство Даних та магію Zero Trust»
Дійові персонажі:
-
Король Даних — володар усіх скарбів Цифрового Королівства.
-
Маг Zero Trust — захищає Королівство та перевіряє кожного, хто входить.
-
Лицар HPE ProLiant Gen12 — оберігає серверні замки та їхній фундамент.
-
Хранителька Alletra — охороняє сховища даних.
-
Вартовий Aruba Networking — контролює мережеві ворота й дороги.
-
Великий Хранитель Часу та Мобільності HPE Zerto Software — повертає час назад і переносить скарби в безпечне місце.
-
Мудреці Королівства — радники, які дбають про безперервність і стійкість.
-
Темні сили — хакери, шифрувальники та природні стихії.

У Цифровому Королівстві Даних настали відносно спокійні часи: лицарі HPE ProLiant Gen12, системи Alletra та вартові Aruba Networking надійно захищали замки від непроханих гостей за допомогою магії Zero Trust. Вороги вже не могли легко проникнути всередину.
Але темні сили виявили нову підступність: хакери, шифрувальники (Ransomware) та природні стихії вирішили завдавати ударів не стільки в лоб, скільки крізь час і хаос. Вони навчилися миттєво запечатувати скарбниці в отруйні зашифровані кристали та викликати шторми, що паралізували цілі провінції.
Тоді мудреці Королівства зрозуміли: мало не впускати ворога — потрібно вміти повернути час назад, якщо біда все-таки сталася, і перенести скарби в безпечне місце за лічені секунди.
І на допомогу Королівству прийшов Великий Хранитель Часу та Мобільності HPE Zerto Software, який знав потрібне чарівне заклинання.
Магія Безперервного Часу (CDP)

На відміну від старих чаклунів, які робили лише рідкісні «знімки» (снапшоти) скарбниць раз на добу, магія Zerto володіла унікальною технологією Continuous Data Protection (CDP):
Магічний Журнал Часу (Journal-based recovery): Zerto записував абсолютно кожну зміну, кожну транзакцію та кожну частинку даних із точністю до секунд.
Відкат на секунди назад (RPO у секундах, RTO у хвилинах): якщо на замок було накладено закляття-шифрувальник, правителю не потрібно було втрачати результати цілого дня роботи. Він просто відкривав Журнал Часу та відмотував стан замку на кілька секунд назад — до того моменту, як ворог встиг завдати удару.
Єдиний купол для складних систем (Application-centric protection): Zerto захищав не просто окремі скрині зі скарбами, а навіть цілі армії та комплекси заклинань (багатокомпонентні застосунки й VM) як єдине ціле, відновлюючи їх миттєво та без збоїв.
Таємне Сховище (HPE Cyber Resilience Vault) та Спорядження Zerto

Щоб протистояти найтемнішим чарам, Zerto об’єднався з орденом лицарів HPE та створив незламну зброю, доступну в різних бойових обладунках:
Enterprise Cloud Edition (ECE): основний щит Королівства. Він забезпечував безперервну реплікацію, захист від катастроф і свободу переміщення даних між хмарами та замками.
Advanced Resilience Edition (ARE) & Cyber Resilience Vault: найвища магія захисту. Zerto надсилав незмінювані (Immutable) копії даних до ізольованого таємного сховища — HPE Cyber Resilience Vault (побудованого на серверах ProLiant, сховищах Alletra та мережах Aruba). Зіткнувшись із закляттям-шифрувальником, сканери в реальному часі виявляли аномалії, а з таємного сховища відновлювався повністю очищений замок.
Сувої Міграції (Migration License): дозволяли безболісно та без зупинки життя Королівства переносити цілі провінції й замки в нові землі або хмари всього за чотири кліки.
Свобода Міжхмарних Подорожей (Multi-Cloud Mobility)
Zerto розірвав ланцюги, що прив’язували Королівство до одного замку чи інфраструктури.
За допомогою його чар дані могли вільно ширяти й миттєво переміщатися:
-
З локальних замків (On-premises) — у Небесні Хмари (Public Cloud).
-
З однієї Хмари — в іншу (Cloud-to-Cloud).
-
І між різними чаклунськими середовищами (гіпервізорами).
Водночас радники Королівства могли проводити безпечні навчання (Non-disruptive testing) у будь-який день, перевіряючи готовність до катастроф без шкоди для життя громадян і без зупинки транзакцій.
Практична цінність для Королівства
Банки та Купці: більше не боялися простоїв і втрати транзакцій — показник RPO у секундах гарантував збереження кожної золотої монети.
Держава та Регулятори: отримували повні звіти про захищеність і миттєво проходили будь-які перевірки за допомогою вбудованої аналітики (HPE Zerto Analytics).
Виробництва та Заводи: працювали без зупинки 24/7, захищені від Ransomware-атак.
Єдиний Епос Захисту HPE
Так у Цифровому Королівстві Даних склалася досконала оборона:
Zero Trust (ProLiant Gen12, Alletra, Aruba Networking) — перевіряє кожного, не довіряє нікому та захищає фундамент і стіни замку.
HPE Zerto Software — керує часом і простором, гарантуючи, що навіть після найстрашнішого нападу чи катастрофи Королівство відновиться за лічені хвилини, не втративши жодної частки свого майна.
Хочете, щоб і ваше цифрове королівство було готове до будь-яких випробувань? Звертайтеся до LANTEC — допоможемо створити захист, здатний швидко повернути все на свої місця.
Авторка статті — Дана Долматова, пресейл-інженер інфраструктурних рішень, Lantec.
Під час війни хмара для багатьох українських організацій стала не просто технологічним інструментом, а способом зберегти роботу, дані та доступність критичних сервісів. Частина державних установ, підприємств критичної інфраструктури, освітніх організацій і великих компаній вимушено переносили сервіси в Azure швидко, часто в умовах дефіциту часу, ризиків для фізичної інфраструктури та невизначеності. У такій ситуації головним питанням було не “наскільки оптимальна архітектура”, а “чи продовжить організація працювати завтра”.
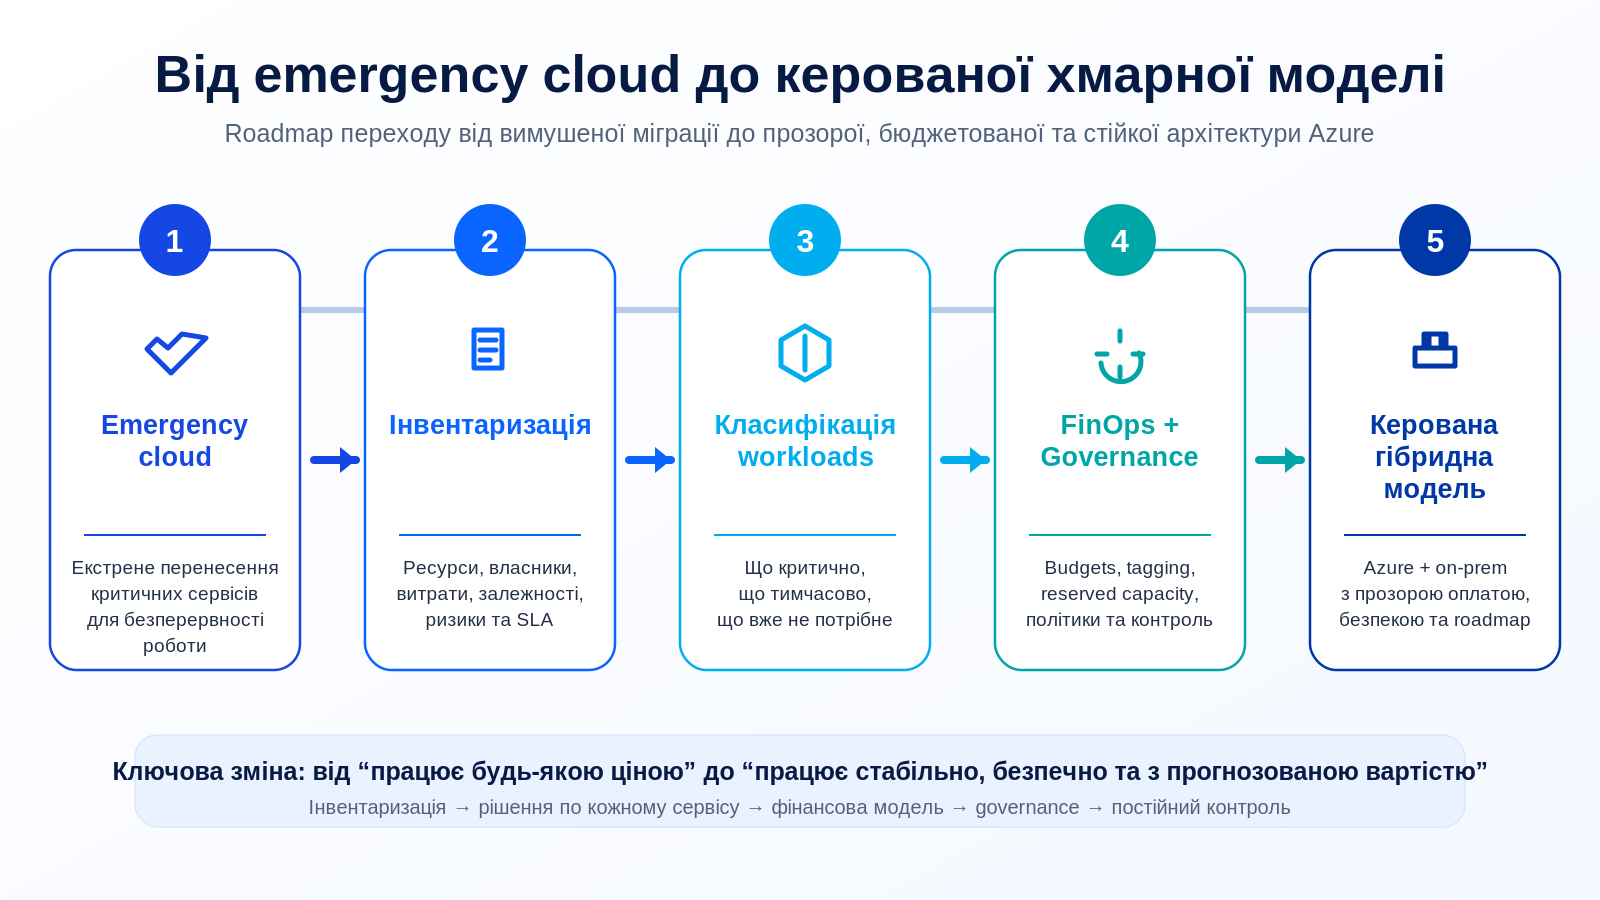
Цей етап був необхідним. Але після стабілізації і перемоги перед багатьма організаціями постане інше завдання: перейти від emergency cloud до керованої хмарної моделі. Тобто зрозуміти, які сервіси справді потрібно залишити в Azure, які можна оптимізувати, які варто повернути on-prem або перевести в гібридну модель, а які вже не мають бізнес-цінності і лише створюють витрати.
В інтерв’ю Forbes керівник Microsoft в Україні та країнах Балтії Євген Кагановський прямо підняв майбутню дилему: Microsoft суттєво підтримує Україну хмарними сервісами, але після завершення війни організаціям доведеться планувати оплату необхідних послуг. Це не негативний сценарій. Навпаки, це перехід до зрілого управління хмарою, коли Azure залишається не екстреним рішенням, а частиною продуманої ІТ-стратегії.
Корсино державному сектору, підприємствам критичної інфраструктури, освітнім установам, великим компаніям, CIO, CFO, керівникам інфраструктури, procurement-командам і всім організаціям, які під час війни користуються cloud-підтримкою або швидко мігрували частину сервісів у Azure.
Головна думка проста: Azure не потрібно сприймати як тимчасовий прихисток або як “дорогу хмару”. Azure має стати керованою платформою, де кожен сервіс має власника, призначення, бюджет, рівень критичності, модель безпеки та зрозуміле місце в майбутній архітектурі.
1. Як Azure допомагає українським організаціям
Для України хмара стала одним із ключових інструментів стійкості. Коли фізичні дата-центри, серверні приміщення, електроживлення, мережеві канали та офіси опинилися під ризиком, можливість швидко перенести сервіси в Azure дала багатьом організаціям шанс зберегти процеси, дані та доступ користувачів.
У державному секторі це могло означати збереження реєстрів, порталів, систем електронної взаємодії та внутрішніх сервісів. Для освіти - можливість продовжувати навчання навіть тоді, коли фізичний кампус або локальна інфраструктура були недоступні. Для критичної інфраструктури - резервну площадку, віддалений доступ, захист даних і сценарії disaster recovery. Для бізнесу - безперервність роботи пошти, ERP, CRM, файлових сервісів, аналітики, резервного копіювання та командної взаємодії.
У перші етапи важливо було діяти швидко. Тому багато рішень приймалися за принципом “перенести найважливіше і забезпечити роботу”. Це нормальна логіка кризового реагування. Проблема виникає тоді, коли emergency-архітектура залишається без перегляду на роки, а організація вже не розуміє, що саме споживає, скільки це коштує, хто є власником ресурсів і які сервіси справді потрібні.
2. Чому “екстрена міграція” і “стійка архітектура” - це різні речі
Екстрена міграція відповідає на питання: як швидко відновити або зберегти роботу? Стійка архітектура відповідає на інші питання: як працювати безпечно, прогнозовано, економічно, масштабовано і з контрольованими ризиками?
Під час екстреної міграції часто не вистачає часу на повноцінний дизайн landing zone, модель управління підписками, тегування, cost allocation, політики безпеки, регулярний перегляд ресурсів, правильний sizing, резервування і документацію. У результаті середовище працює, але може бути складним для управління.
Типові наслідки такої моделі: ресурси без власника, тестові середовища, які продовжують працювати 24/7, завищені розміри віртуальних машин, невикористані диски та snapshots, дублювання backup, відкриті публічні IP, відсутність бюджетів, слабке розділення production і test, відсутність єдиної картини витрат для фінансової команди.
Стійка архітектура вимагає іншого підходу. Кожен workload має бути описаний: яку бізнес-функцію він підтримує, які має залежності, який RTO/RPO потрібен, хто власник, яка модель доступу, які дані обробляються, скільки він коштує, що буде у випадку збою, які є альтернативи.
3. Які питання потрібно задати вже зараз
Перехід до керованої оплати потрібно починати не тоді, коли пільговий період закінчився, а заздалегідь. І перший крок - інвентаризація. Організація має побачити повну картину Azure-середовища: subscriptions, resource groups, віртуальні машини, диски, мережі, бази даних, storage, backup, публічні IP, інтеграції, ліцензійні залежності та споживання.
Друге питання: що є критичним? Не всі сервіси мають однакову цінність. Одні забезпечують роботу державної послуги, банківського процесу або виробничої системи. Інші є допоміжними. Треті були створені для тесту і вже не потрібні. Без класифікації неможливо приймати правильні рішення.
Третє питання: що було тимчасовим? На початку війни багато ресурсів могли створюватися для конкретного проєкту, міграції, аварійного сценарію або резервної копії. Після стабілізації такі ресурси потрібно переглянути: залишити, об’єднати, оптимізувати або вивести з експлуатації.
Четверте питання: що дороге і чому? Висока вартість не завжди означає проблему. Дорогий сервіс може бути критичним і правильно спроєктованим. Проблема - це коли витрати не пояснені бізнес-цінністю, власником, SLA або ризиками. Тому аналіз варто робити не тільки технічно, а й фінансово: по департаментах, проєктах, середовищах і сервісах.
П’яте питання: що не використовується? У хмарі легко створити ресурс і забути про нього. Але за невикористані диски, snapshots, публічні IP, storage, backup або завищені SKU все одно формується рахунок. Саме тому регулярний огляд ресурсів має стати процесом, а не разовою дією.
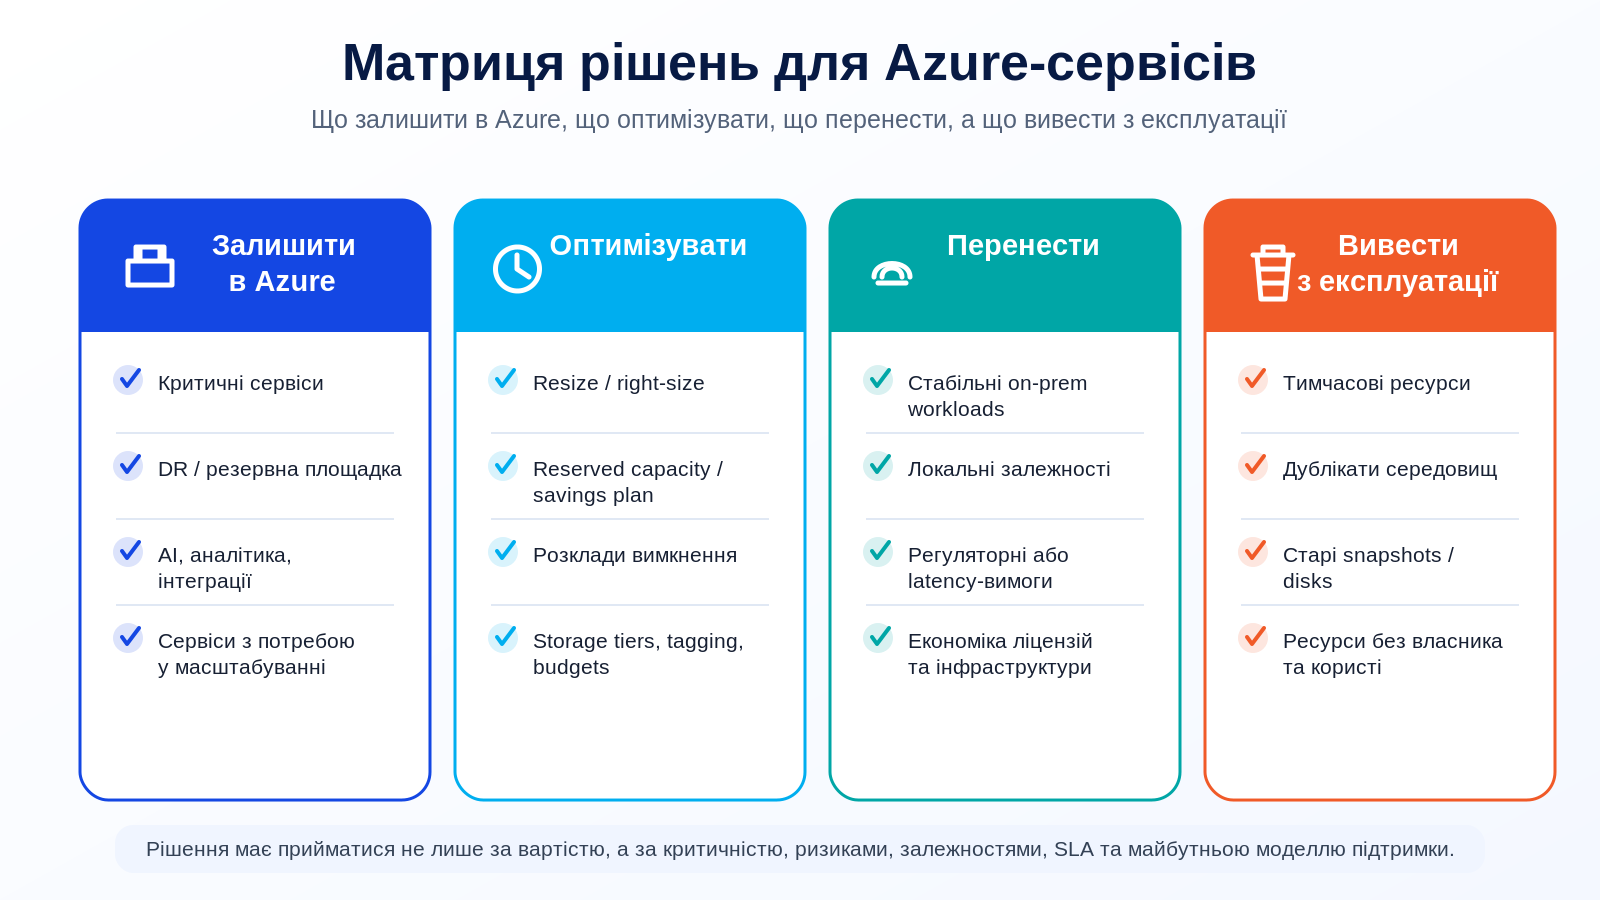
4. Як підготувати модель оплати: FinOps, бюджети, reserved capacity, hybrid architecture
Керована оплата Azure починається з прозорості. Фінансова команда має бачити витрати не як один великий рахунок, а як структуру: який сервіс, для якого підрозділу, в якому середовищі, з якою метою і з якою динамікою. Для цього потрібні tagging, cost analysis, budgets, alerts і правила відповідальності.
Microsoft Cost Management надає інструменти для аналізу, моніторингу та оптимізації витрат Microsoft Cloud, зокрема бюджети, cost alerts, cost analysis і рекомендації. Azure Advisor допомагає знаходити можливості для оптимізації, наприклад resize або shutdown недовантажених віртуальних машин, а також рекомендації щодо reservations і savings plans. Але інструмент сам по собі не замінює процес. Потрібна дисципліна прийняття рішень і власники витрат.
FinOps для Azure простими словами - це спосіб об’єднати IT, фінанси та бізнес навколо спільного управління хмарними витратами. Не “IT щось споживає, а фінанси отримують рахунок”, а спільна модель: IT пояснює архітектуру, бізнес визначає критичність, фінанси бачать бюджет, procurement планує закупівлі, а керівництво розуміє, за що платить.
Reserved capacity і savings plans варто розглядати лише після інвентаризації і rightsizing. Якщо купити резервування під завищені або тимчасові ресурси, економія може перетворитися на нове зобов’язання. Спочатку потрібно зрозуміти стабільне споживання, потім оптимізувати розміри, потім вирішувати, які ресурси доцільно покривати reservations або savings plans.
Hybrid architecture також має бути частиною рішення. Не все обов’язково має залишатися в Azure. Частину сервісів варто залишити в хмарі через стійкість, масштабування, disaster recovery, AI, аналітику або глобальну доступність. Частину можна повернути on-prem, якщо є стабільна локальна інфраструктура, регуляторні вимоги, низька latency-залежність або економічне обґрунтування. Частину варто залишити в гібридній моделі: Azure як резервна площадка, on-prem як основне середовище або навпаки.
5. Як LANTEC може допомогти зробити cloud transition plan
LANTEC вже допомагає своїм клієнтам реорганізувати emergency cloud в керовану хмарну модель для прогнозованого виходу з пільгового періоду. Для цього потрібен не один аудит рахунку, а комплексний cloud transition plan: технічний, фінансовий і архітектурний.
Перший етап - discovery. Ми збираємо інформацію про поточне Azure-середовище, підписки, ресурси, мережі, доступи, backup, залежності, критичні сервіси, власників, наявні витрати та поточні ризики. Мета - отримати реальну карту середовища, а не лише список ресурсів у порталі.
Другий етап - класифікація workload-ів. Разом із замовником визначаємо, що є критичним, що тимчасовим, що потребує оптимізації, що можна перенести, а що потрібно вивести з експлуатації. На цьому етапі важливо поєднати технічну логіку з бізнес-пріоритетами.
Третій етап - cost та risk assessment. Ми аналізуємо, де формуються витрати, які ресурси недовантажені, де є ризики безпеки, які сервіси не мають власника, де потрібні бюджети, теги, політики, reserved capacity, savings plans або архітектурні зміни.
Четвертий етап - цільова архітектура. Формуємо рекомендації: що залишити в Azure, що оптимізувати, що перенести в on-prem або hybrid, які політики governance впровадити, як контролювати витрати, які сервіси потребують DR, backup, security hardening або модернізації.
П’ятий етап - roadmap і регулярний контроль. Cloud transition plan не має завершуватися презентацією. Потрібні пріоритети, відповідальні, бюджетна модель, план впровадження, контрольні точки і регулярний перегляд споживання. Саме це відрізняє керовану хмару від хаотичного набору ресурсів.
Після перемоги хмарні сервіси не втратять значення. Навпаки, Azure залишиться важливою платформою для стійкості, безпеки, disaster recovery, аналітики, AI та гібридної інфраструктури. Але логіка використання зміниться: замість екстреного перенесення потрібно буде перейти до керованої моделі.
Це означає, що кожна організація має чесно відповісти: які сервіси справді потрібні, скільки вони коштують, які ризики закривають, хто за них відповідає, що можна оптимізувати і яку роль Azure має відігравати у майбутній архітектурі.
Правильна стратегія - не чекати завершення пільгового періоду, а підготувати cloud transition plan заздалегідь. Тоді перехід до оплати не стане шоком для бюджету, а буде прогнозованим етапом розвитку інфраструктури.
Підготуйте cloud transition plan заздалегідь. LANTEC допоможе оцінити поточне використання Azure, ризики, витрати та оптимальну модель після завершення пільгового періоду.
Ви готові до змін?
Ви готові дивитися в майбутнє?
Ви тверезо оцінюєте ситуацію?
Ви готові змінитися? Якщо так, тоді ця стаття для вас.
Постквантова криптографія (ПКК) сьогодні є частиною публічного дискурсу в багатьох технологічних компаніях. Однак багато хто в нашій галузі досі з трудом розуміє її тонкощі, і занадто мало хто усвідомлює, чому перехід до ПКК вже необхідний. Тому давайте розглянемо, як її слід розуміти і що вона означає для осіб, які приймають рішення сьогодні. Щоб грамотно говорити про постквантову криптографію, ми повинні викласти деякі фундаментальні принципи квантових обчислень, що має на увазі, нехай навіть поверхневе, вивчення квантової механіки. Сама тема дуже складна і широка, тому ми просто хочемо прояснити деякі з найосновніших принципів у надії розвіяти міфи про постквантову криптографію.
Основні принципи
Що таке квантові обчислення?
Класичні комп'ютери/сервери зберігають і обробляють інформацію за допомогою електричних сигналів, які можуть перебувати тільки у двох основних станах: висока або низька напруга. Відповідно, ми позначаємо ці стани за допомогою двоїчної мови, що складається з нулів і одиниць. Усе, що робить класичний комп'ютер/сервер — від ОС і програм, які він запускає, до зображень і відео, що відображаються — зрештою являє собою довгий ланцюжок цих нулів і одиниць.
Квантовий комп'ютер схожий на нього тим, що також використовує деяку фізичну систему як основу для всіх своїх обчислень, але замість класичних електричних сигналів він використовує квантові частинки, такі як електрони або фотони. І ці елементи поводяться відповідно до законів квантової механіки.
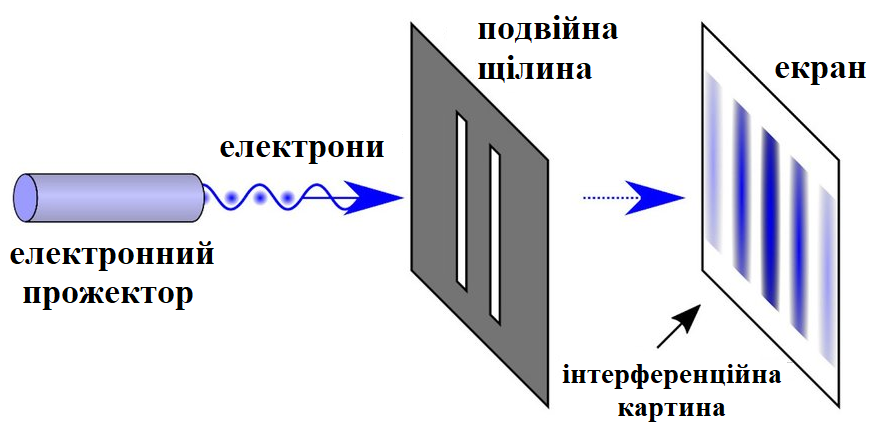
Одним із відомих прикладів цього є експеримент із подвійною щілиною, проведений Томасом Юнгом на початку XIX століття. Коли світло проходить через дві щілини, воно створює інтерференційну картину, ніби це хвиля, що проходить через обидві щілини одночасно. Однак якщо використати вимірювальний прилад, щоб визначити, через яку саме щілину проходить світло, інтерференційна картина зникає. У цьому випадку світло поводиться так, ніби воно складається з частинок. Саме це в квантовій механіці називається корпускулярно-хвильовий дуалізм. Протягом багатьох років це явище неодноразово відтворювалося з використанням різних фотонів або частинок, і воно є однією з ключових ідей, що лежать в основі квантових обчислень.
Что такое кубит?
Який зв'язок між експериментом із подвійною щілиною та квантовими комп'ютерами? Простіше кажучи, квантові комп'ютери використовують квантовий стан частинок як представлення фундаментальної інформації, що лежить в основі квантових обчислень. Якщо класичні комп'ютери використовують біти, то квантові комп'ютери використовують квантові біти або їх називають ще «кубіти». Так само, як біт представляє діапазон напруги, кубіт може символізувати поляризацію фотона або спін електрона. Як у класичних, так і в квантових обчисленнях система повинна провести вимірювання, щоб визначити значення біта або кубіта. Однак, на відміну від класичної механіки, експеримент із подвійною щілиною показує, що квантові частинки поводяться зовсім по-різному до і після вимірювання.
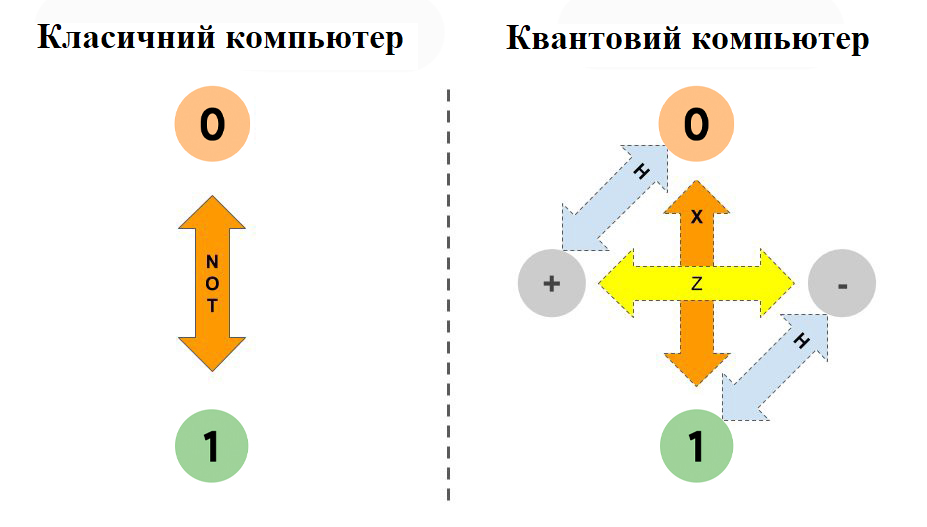
Подібно до класичної обчислювальної техніки, де біти перебувають у двійковому стані, представленому або 0, або 1, у квантових обчисленнях кубіти розглядаються в межах двох станів, таких як, наприклад, два енергетичні рівні або два кутові моменти. Однак, на відміну від класичних бітів, стани яких взаємовиключають один одного (тобто або 1, або 0), кубіти перебувають у суперпозиції двох станів, тобто поводяться так, ніби вони перебувають у комбінації станів 0 і 1, подібна до хвилі, що проходить через обидві щілини одночасно. У результаті стани 0 і 1 в кубіті існують в амплітуді ймовірності, яка визначає ймовірність фактичного отримання 0 або 1 при вимірюванні.
Як тільки система проводить вимірювання, суперпозиція кубіта стискається до 0 або 1, що призводить до завершення квантового обчислення. Це точно так само, як при вимірюванні того, через яку щілину проходить світло в згаданому вище експерименті з подвійною щілиною. У результаті квантові алгоритми використовують ретельно розроблені операції для зміни амплітуд ймовірностей кубітів. Простіше кажучи, квантовий алгоритм маніпулює ймовірнісними амплітудами, посилюючи правильні результати і пригнічуючи неправильні, так що при проведенні вимірювання отримується правильний результат.
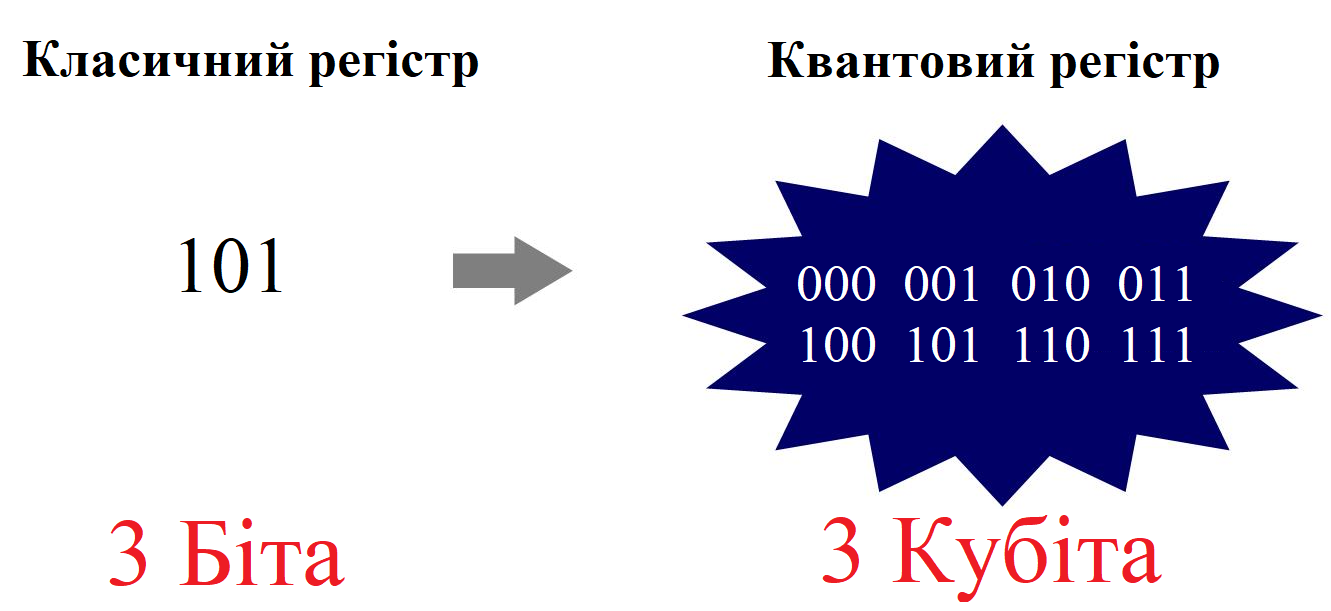
Основна потенційна перевага квантових обчислень перед класичними полягає в здатності використовувати суперпозицію для паралельного дослідження безлічі можливостей. У той час як класичний комп'ютер змушений оцінювати можливості крок за кроком, квантовий комп'ютер може, при вирішенні певних завдань, використовувати свою квантову поведінку для скорочення кількості необхідних операцій і досягнення значного прискорення. Однак таке підвищення продуктивності застосовне не до всіх завдань. Як правило, квантові комп'ютери пере перевершують класичні у вирішенні певних класів завдань, таких як оптимізація, моделювання квантових систем, а також деякі додатки в галузі криптографії та пошуку.
Квантова загроза
Що таке криптографічно значущий квантовий комп'ютер?
Хоча квантові комп'ютери вже існують у різних лабораторіях по всьому світу, жоден із них наразі не становить загрози для класичних криптографічних алгоритмів. Як це прийнято називати в галузі, вони не є «криптографічно значущими». Однак ми явно рухаємося до появи «криптографічно значущого квантового комп'ютера» або далі скорочено КЗКК, тобто майбутнього квантового комп'ютера, здатного зламати криптографію з відкритим ключем за рахунок запуску відмовостійких квантових алгоритмів, що використовують велику кількість кубітів. За деякими оцінками, до появи КЗКК залишилося від 10 до 15 років, але зробити будь-який достовірний прогноз дуже складно. Причина в тому, що для того, щоб стати криптографічно значущим, квантовий комп'ютер повинен не тільки обробляти значну кількість кубітів, але й відповідати додатковим вимогам.
Квантові комп'ютери мають труднощі з розпізнаванням і виправленням помилок або збоїв. КЗКК повинен буде виявляти і виправляти помилки в режимі реального часу. Сучасні квантові комп'ютери також схильні генерувати логічні кубіти, вразливі до помилок. Щоб стати придатним для застосування в криптографії, квантовий комп'ютер повинен буде підтримувати сотні логічних кубітів. Логічний кубіт — це кубіт, закодований з використанням безлічі фізичних кубітів для захисту від помилок. Ця ідея аналогічна кодам з виправленням помилок, які використовуються в пам'яті з ECC. Нарешті, КЗКК повинен буде виконувати обчислення, що включають мільйони операцій з квантовими логічними елементами, і залишатися стабільним протягом щонайменше кількох годин. Поки квантовий комп'ютер не зможе задовольнити всі ці критерії, він не матиме криптографічної значущості або сенсу.
У чому полягають квантові загрози?
Класичні алгоритми
Як квантовий комп'ютер зможе зламати класичні криптографічні алгоритми? Одним із найчастіше згадуваних методів є алгоритм Шора, названий на честь математика Пітера Шора. Щоб зрозуміти, як він працює, важливо зазначити, що багато сучасних криптографічних алгоритмів базуються на тому, що розклад великих цілих чисел на прості на класичних комп'ютерах є надзвичайно складною і трудомісткою задачею. Дійсно, у той час як множення двох чисел відбувається швидко і легко, визначення того, які прості числа потрібно помножити одне на одне, щоб отримати велике число, займає стільки часу, що робить цей обчислювальний процес практично неможливим.
По суті, у цьому і полягає суть алгоритмів шифрування, таких як RSA (Rivest-Shamir-Adleman). Велике число являє собою зашифровані дані. Два прості числа — це відкритий і закритий ключі. Якщо у когось є обидва ключі, розшифрування даних відбувається дуже швидко і просто. Якщо у когось є тільки відкритий ключ, підбір закритого ключа методом перебору вважається неможливим. Наприклад, злом шифрування RSA з використанням 2048-бітних цілих чисел зайняв би приблизно 300 трильйонів років. Для порівняння: згідно з популярною статтею, опублікованою у 2021 році, та ж операція зайняла б теоретично вісім годин і 20 мільйонів “шумних” кубітів на квантовому комп'ютері.
Алгоритми Шора та Гровера
В основі цих алгоритмів лежать численні складні математичні принципи, які пояснюють, як квантовий комп'ютер, що застосовується в криптографії, може дуже швидко зламати шифрування RSA. Алгоритми Шора та Гровера (ще один принцип злому) по суті є квантовими алгоритмами, які дозволяють квантовим комп'ютерам виконувати певні обчислення зі швидкістю, що значно перевищує швидкість класичних комп'ютерів. Тому, коли в галузі говорять про те, що квантові комп'ютери становлять загрозу для сучасних криптографічних стандартів, це частково пов'язано з тим, що ці алгоритми математично продемонстрували, як це може статися.
Якщо говорити максимально спрощено, алгоритм Шора продемонстрував, як квантовий комп'ютер може виконувати пошук порядку та інші складні обчислення з неймовірною швидкістю. По суті, це можливо завдяки тому, що квантові комп'ютери можуть маніпулювати кількома кубітами для виконання модульної арифметики та інших операцій зі швидкістю, що значно перевищує швидкість класичних комп'ютерів. У результаті алгоритм Шора дозволяє в геометричній прогресії прискорити злом шифрування RSA шляхом розкладу великих чисел на прості множники з набагато меншою кількістю обчислювальних кроків, що серйозно підриває його криптографічну значущість.
Аналогічним чином, Лов Ґровер представив алгоритм квантового пошуку, який можна використовувати для перебору симетричного ключа методом «грубої сили». Це стосується як шифрів типу AES, так і конструкцій із ключем, таких як HMAC-SHA-256. Класичний перебір методом «грубої сили» вимагав би перевірки практично всіх можливих ключів. При типовому розмірі ключа в 128 біт перевірка всіх можливих ключів вимагала б 2¹²⁸ виконань базового криптографічного алгоритму. Простіше кажучи, теоретично нам довелося б перевірити всі можливі значення ключа. З іншого боку, алгоритм Гровера використовує квантові обчислення, завдяки чому кожне обчислення збільшує амплітуду ймовірності правильного ключа, так що вже після приблизно 2⁶⁴ обчислень правильний ключ можна визначити з дуже високою ймовірністю.
AES-192 та AES-256
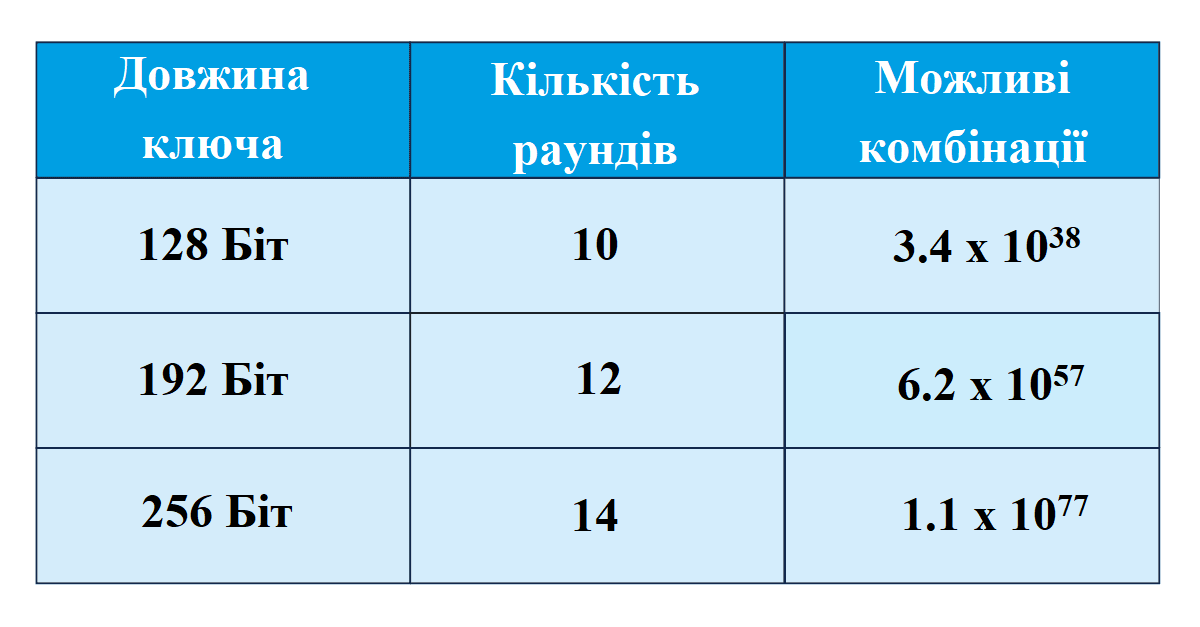
Хоча квантові комп'ютери здатні одночасно обробляти обсяг інформації, який для класичних комп'ютерів/серверів просто незбагненний, що робить деякі алгоритми шифрування вразливими, Національний інститут стандартів і технологій Міністерства торгівлі США (NIST) також публічно заявив, що не всі сучасні алгоритми шифрування втратили свою безпеку. Наприклад, вони заявили, що «AES-192 і AES-256 залишатимуться безпечними ще дуже довго». Це пов'язано з тим, що алгоритм Гровера має обмеження щодо реалізації, які стримують його здатність зламувати цей тип шифрування методом перебору. Окрім того, що алгоритм вимагає значних обчислювальних ресурсів квантового комп'ютера, його практична перевага також знижується через складність його ефективного розпаралелювання.
Підготовка до майбутнього
Хоча важливо не перебільшувати ризик, який КЗКК становить сьогодні, не менш важливо і не недооцінювати його. У міру вдосконалення квантових комп'ютерів те, що сьогодні вважається прийнятним, завтра просто не витримає випробування часом. Це створює проблему для деяких технологій цифрового підпису та сертифікації, які мають залишатися актуальними протягом десятиліть, а то й довше. Аналогічним чином, навіть якщо блокчейн (заснований на класичній криптографії з відкритим ключем) сьогодні відповідає всім вимогам безпеки, його нездатність протистояти атакам з боку квантового комп'ютера через 20 років фактично зробить його марним. Зловмисники також застосовують стратегію «збирай зараз, розшифровуй пізніше», яка спонукає їх накопичувати величезні обсяги конфіденційних даних, знаючи, що в результаті вони зламають їхні ключі шифрування, як тільки квантові комп'ютери стануть достатньо потужними.
Тому недивно, що, навіть якщо до появи КЗКК ще далеко, а деякі сучасні алгоритми ще довго залишатимуться актуальними, багато хто вже переходить на постквантову криптографію (ПКК) — тобто на криптографічну схему, яка буде стійкою до квантових комп'ютерів, незважаючи на їхні можливості.
Коли КЗКК може стати реальністю?
Державні регуляторні органи по всьому світу намагаються показати приклад і представили дорожні карти впровадження ПКК. Як і Агентство національної безпеки США (АНБ), багато хто визнає, що «не знає, коли з'явиться КЗКК». Однак багато хто вже почав готуватися до цього, оскільки перехідний період займає час — іноді 10 років і більше — від остаточної стандартизації до повної системної інтеграції. Простіше кажучи, перехід на квантово-стійкі алгоритми вже триває, ринки рухаються в напрямку ПКК, а державні відомства оприлюднили рекомендовані графіки переходу на ПКК, щоб підготуватися до «Q-дня» — дня, коли КЗКК стане реальністю.
Різні світові регуляторні органи (Європейська комісія разом із Європейським агентством з мережевої та інформаційної безпеки/ENISA, Національний інститут стандартів і технологій США/NIST, Агентство національної безпеки США/NSA та багато інших) опублікували різні дорожні карти, згідно з якими до 2035 року перехід до ПКК має бути завершений для максимально можливої кількості систем (або алгоритми, вразливі для квантових атак, мають бути заборонені до 2035 року) з різними ключовими датами досягнення цих цілей.
Поява ПКК
Де потрібна ПКК?
Не кожна інфраструктура однаковою мірою зазнає впливу квантових комп'ютерів. Не кожне обчислювальне обладнання має переходити на ПКК з однаковою швидкістю. Однак було б неправильно припускати, що пріоритет надається виключно суперкомп'ютерам, які зберігають секрети національної безпеки. Насправді в багатьох випадках основним фактором, що визначає швидкість переходу того чи іншого пристрою на ПКК, є не стільки його функціональність, скільки термін експлуатації. Навіть такий, здавалося б, невинний пристрій, як промислове обладнання, стає вразливим, оскільки він розрахований на десятиліття експлуатації. Дійсно, якщо його механізм безпечного завантаження або оновлення бездротовою мережею не захищений від квантових атак, така система може стати вразливим місцем для всієї компанії.
Наприклад, найбільшому ризику піддаються одні з найменших і, здавалося б, найневинніших пристроїв у світі, такі як модулі довіреної платформи TPM (Trusted Platform Module). Ці невеликі захищені елементи складають основу «кореня довіри», що відповідає за підпис прошивки, генерацію та управління ключами, а також забезпечення безпеки послідовності завантаження сервера/ПК/ноутбука. Усі квантово-стійкі сертифікати TLS у світі, які захищають мережу інтернет, втрачають сенс, якщо кореневий ланцюжок довіри пристрою скомпрометований. Аналогічним чином уряди, компанії та установи вдаються до використання захищених ідентифікаторів та інших компонентів для збереження особистої інформації. Ці ідентифікатори служать дуже довго і часто використовуються для підписання документів або підтвердження особи. Тому вразливість такого ідентифікатора може мати катастрофічні наслідки.
Що таке нові стандарти постквантової криптографії і чим вони відрізняються від класичних алгоритмів?
Складніші математичні задачі
У рамках підготовки до переходу на ПКК багато хто запитує, що саме робить алгоритм стійким до квантових обчислень. Хоча математика, що лежить в основі, досить складна, основна ідея полягає у використанні алгоритмів, які вимагають більших обчислювальних ресурсів, ніж просте розкладання на множники, наприклад криптографії на основі ґраток.
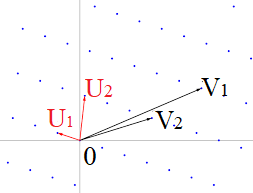
Простіше кажучи, криптографія на основі ґраток використовує набір координат, які можна умовно представити у вигляді точок на двовимірній площині, для вирішення математичних задач, таких як багатовимірні структуровані математичні задачі, у яких використовується саме це ґратчасте представлення. Потім алгоритми використовують складні математичні інструменти, такі як перетворення теорії чисел у криптографії на основі ґраток, щоб ще більше збільшити обчислювальну інтенсивність і тим самим посилити свою квантову стійкість.
Висока ресурсоємність
ПКК також використовує деякі очевидні, але дуже ефективні методи для посилення безпеки, такі як збільшення довжини ключів. Як ми бачили на прикладі симетричного блочного шифрування AES, навіть якщо криптографія, що лежить в основі, концептуально вразлива для квантового комп'ютера, достатньо довгий ключ може означати, що атака все одно займе занадто багато часу або ресурсів, щоб бути доцільною. Аналогічним чином, деякі квантово-стійкі алгоритми використовують стан, схожий на випадкове значення, наприклад лічильник, який створюється при кожному формуванні підпису, а потім перевіряється для підтвердження походження повідомлення або виявлення його перехоплення. Класичні алгоритми, такі як RSA та ECDSA, є «незалежними від стану» (stateless). Це означає, що для створення унікального та безпечного підпису не потрібно відстежувати історію підписаних раніше повідомлень або оновлювати внутрішній лічильник (стан) після кожної операції. Деякі механізми ПКК є залежними від стану (stateful), що додає ще один рівень безпеки, який запобігає повторному використанню підпису.
Список алгоритмів ПКК
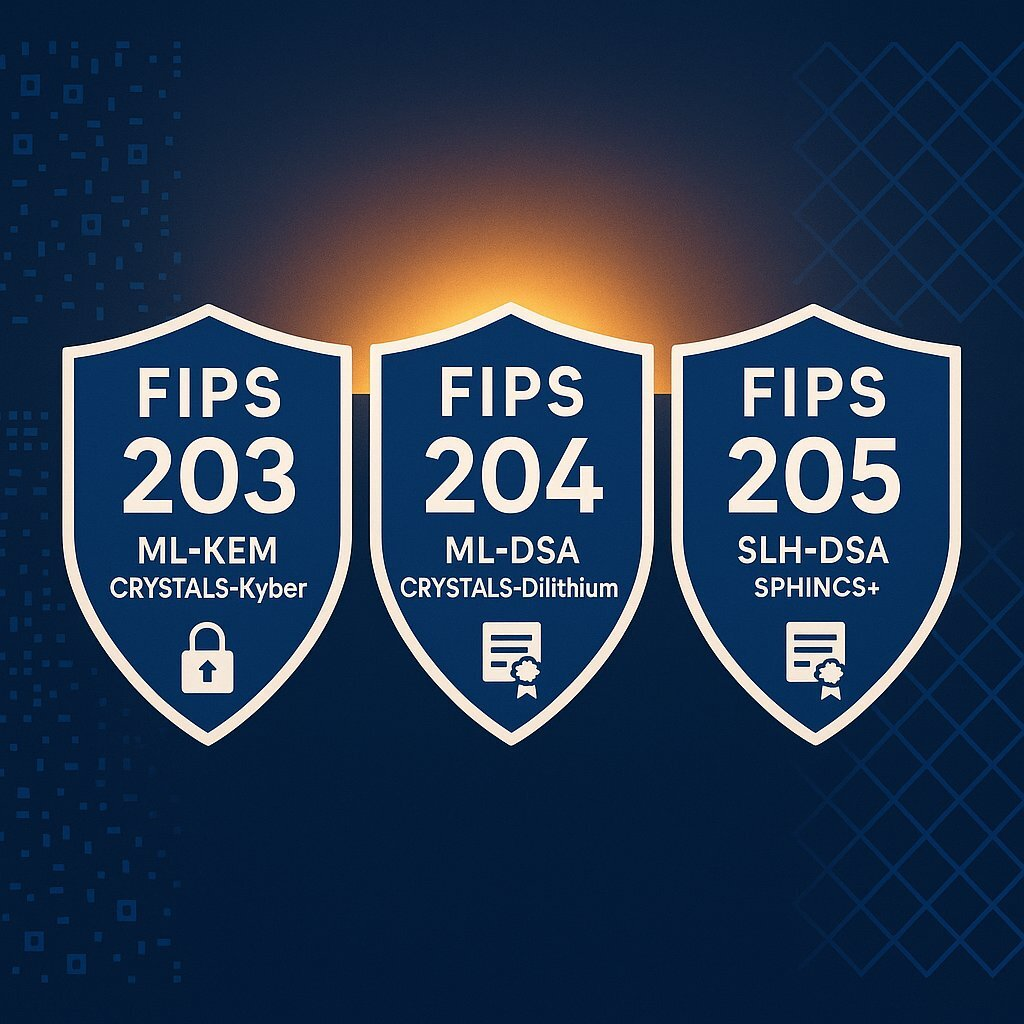
У 2024 році Національний інститут стандартів і технологій США/NIST опублікував три остаточні стандарти ПКК: ML-KEM (FIPS 203), ML-DSA (FIPS 204) та SLH-DSA (FIPS 205). ML означає «Module-Lattice» (Модуль-ґратка). KEM означає «Key Encapsulation Mechanism» (Механізм інкапсуляції ключа) і стосується способу використання ключа в незахищеному каналі. Два інші стандарти використовуються для алгоритму цифрового підпису (DSA), що дозволяє перевіряти автентичність. SLH розшифровується як «Stateless Hash-Based» (безстанний, заснований на хешуванні) і використовує обчислення хешів замість ґратки. Ці алгоритми вже забезпечують міцну основу для квантової стійкості. Наприклад, компанія Apple вже використовує ML-KEM, а Google обрала ML-DSA та SLH-DSA, хоча її система управління ключами в хмарі підтримує всі три алгоритми. Так само ведеться робота і над стандартизацією нових алгоритмів — LMS або Leighton-Micali Signature, та XMSS або eXtended Merkle Signature Scheme, а також стандартизацією ще одного підпису на основі ґраток — FN-DSA (FIPS 206).
Які проблеми виникають при переході на ПКК?
Аналіз (інвентаризація)
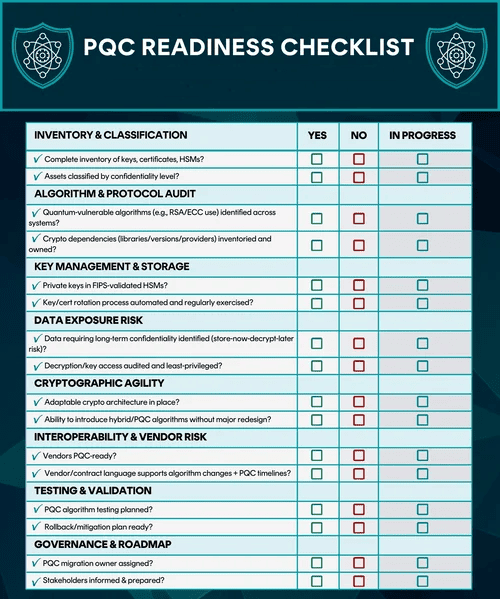
Агентство з кібербезпеки та захисту інфраструктури США/CISA опублікувало свої рекомендації щодо забезпечення готовності до квантових загроз, у яких не згадувався жоден алгоритм за ім'ям/назвою. Однак у них було наведено великий перелік для «складання криптографічного інвентарного списку», що допоможе компаніям оцінювати ризики, виявляти вразливі протоколи, встановлювати обмеження щодо сертифікації та визначати всі залежності, на які вплине перехід на квантово-стійкі алгоритми. Але тут криються підводні камені! Наприклад, ІТ-відділи можуть дуже легко зосередитися на оновленні своєї хмарної інфраструктури та повністю забути про смарткарти, апаратні модулі безпеки або VPN, які її співробітники використовують для доступу до цих сервісів.
Криптогнучкість
Саме тому в галузі з'явився термін «криптографічна (крипто) гнучкість», який Національний інститут стандартів і технологій США/NIST визначає як «можливості, необхідні для заміни та адаптації криптографічних алгоритмів у протоколах, програмах, програмному забезпеченні, апаратному забезпеченні, вбудованому ПЗ та інфраструктурах при збереженні безпеки та безперервності операцій». Простіше кажучи, це здатність перейти на ПКК з мінімальними перебоями у нормальній роботі. Конкретно це означає наявність широкого асортименту продуктів, що використовують криптографію, розробку інфраструктури, яка абстрагує алгоритми за допомогою API, або забезпечення можливості простого та безпечного оновлення всього програмного забезпечення. Криптогнучкість також передбачає проведення тестів для перевірки здатності організації використовувати кілька алгоритмів і переходити на новий, коли спільнота фахівців з безпеки виявляє вразливості.
Криптогнучкість є ключовою вимогою для будь-якої міграції до ПКК. Криптогнучкість важлива не лише для скорочення часу простою та втрат продуктивності, але й для забезпечення безпеки міграції. Наприклад, якщо при міграції ігноруються принципи криптогнучкості та жорстко прописуються схеми сертифікатів, протоколи, контейнери ключів тощо, то компанія не лише наражається на більший ризик через некоректну реалізацію, але й значно ускладнює будь-яке оновлення системи безпеки, що призводить до додаткових простоїв і втрати продуктивності. Якщо перехід на технології, стійкі до квантових атак, і вчить чогось, то це тому, що вимоги до безпеки постійно еволюціонують, і створення організації, здатної оперативно адаптуватися до змін у галузі криптографії, — найкращий спосіб реагувати на ці зміни.
Як ПКК впливає на обчислювальні системи?
Перехід на ПКК матиме глибокий вплив на те, як ІТ-відділи розробляють, упроваджують та обслуговують обчислювальні ресурси. Щоб упоратися з викликами, пов'язаними з переходом на ПКК, ІТ-фахівцям доведеться працювати за кількома напрямами як на апаратному, так і на програмному рівнях. З точки зору апаратного забезпечення деякі постквантові схеми вимагають використання ключів, підписів та зашифрованих текстів більшого розміру, а також виконання більш обчислювально містких операцій. У результаті системам знадобиться більше пам'яті та дискового простору для обробки довших ключів, сертифікатів і проміжних даних. Їм також знадобляться вищі обчислювальні потужності або спеціалізовані прискорювачі, щоб утримати затримку та енергоспоживання в прийнятних межах. Нарешті, деяким платформам можуть знадобитися нові системні архітектури та модулі безпеки для підтримки нових криптографічних робочих процесів. І це те, що чекає на нас у майбутньому.
Перехід на ПКК — це значно більше, ніж просто використання нових алгоритмів. Він вимагає посилення захисту від атак на фізичному рівні. Навіть найнадійніший квантово-безпечний алгоритм виявиться марним, якщо зловмисники зможуть скористатися вразливостями після його реалізації. Наприклад, без належних заходів безпеки хакер може відновити секретні ключі або конфіденційні дані, спостерігаючи за енергоспоживанням, електромагнітним випромінюванням, різницею в часі або збоями, що виникають у системі. Щоб протистояти таким атакам за подібними каналами, системи повинні містити засоби захисту та контрзаходи на апаратному рівні, які гарантують, що квантово-стійкі алгоритми не будуть скомпрометовані через неквантові вразливості. Іншими словами, навіть найбезпечніший алгоритм ПКК забезпечить лише ілюзорний захист, якщо його реалізація вразлива до атак із використанням доступного обладнання.
Обладнання, яке вже готове або частково готове до ПКК
SAN-комутатори
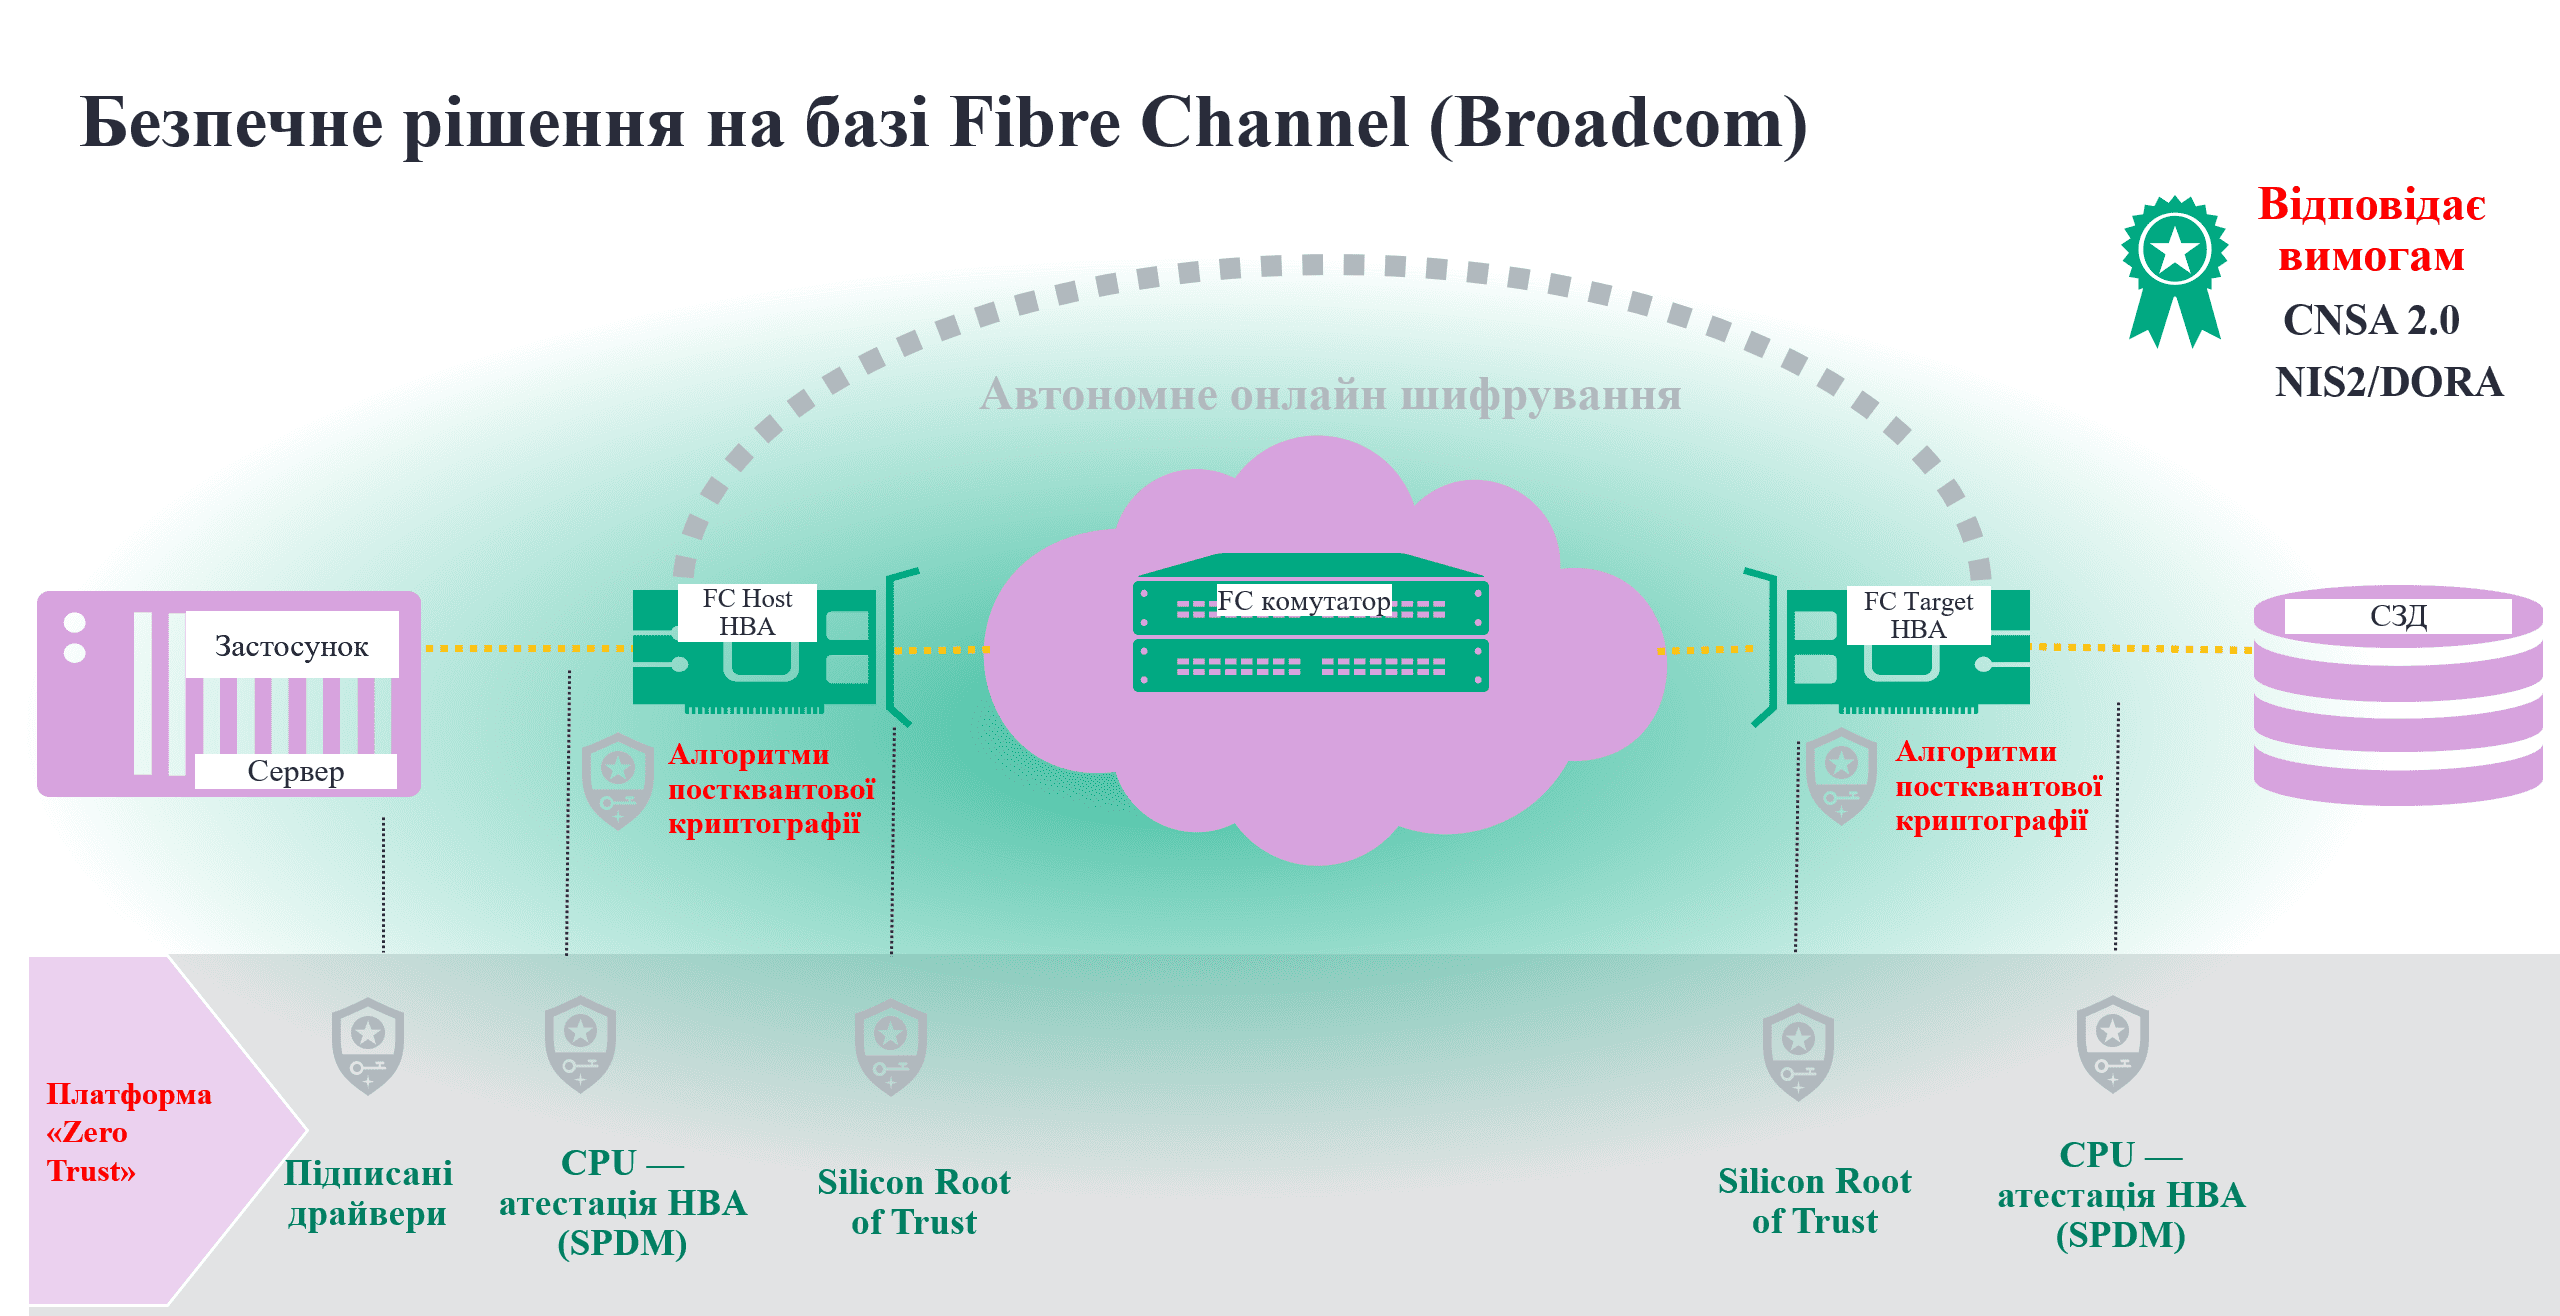
Компанія Broadcom (Brocade) оголосила, що у версії SAN-комутаторів FOS 10.0 уже наявна підтримка ПКК. Вбудована прошивка містить розширені функції захисту від квантових загроз, призначені для забезпечення безпеки даних, що передаються в процесі експлуатації, використовуючи алгоритми ML-KEM-768 (для інкапсуляції ключів) та ML-DSA-65 (для цифрових підписів). Також Emulex HBA, що випускаються цією компанією, підтримують наскрізне шифрування AES-GCM-256 під час передачі. Так само використовуються параметри ML-DSA-87 та ML-KEM-1024 для SPDM (Security Protocol and Data Model) і LMS Silicon Root of Trust, що робить її неразомливою до квантових атак. Для роботи з FOS 10.0 та доступу до цих функцій безпеки потрібні платформи 7-го та 8-го поколінь (64 Гб/с та 128 Гб/с комутатори) з наявністю дійсного сертифіката TruFOS.
Сервери
Сервери компанії HPE ProLiant покоління 12 (Gen 12) розроблені для задоволення потреб у сфері безпеки відповідно до алгоритмів CNSA 2.0 і відповідають стандарту FIPS 140-3 рівня 3. Так, у 12-му поколінні з'явилася нова технологія в мікросхемі віддаленого управління HPE iLO 7, що лежить в основі системи безпеки сервера. Окрім посилення кремнієвого кореня довіри (Silicon root of trust), HPE розробила спеціалізований процесор безпеки під назвою Secure Enclave, який забезпечує середовище, стійке до квантових атак, де зберігаються ключі, паролі та інша конфіденційна інформація. Це гарантує, що ці дані, які є частиною процесу завантаження, не можуть бути скомпрометовані або змінені.
Наприклад, такі відомі компанії, що спеціалізуються на ІБ, як Thales та DigiCert, забезпечують нативну інтеграцію з інфраструктурою HPE (включаючи лінійки серверів ProLiant, Alletra та платформу HPE GreenLake), надаючи апаратно-орієнтовану довіру, централізоване управління ключами та захист даних, і це про багато що свідчить.
Мережеве обладнання
Підрозділ HPE Aruba Networking просуває ПКК у межах скоординованої багаторічної програми, орієнтованої на сфери, безпосередньо піддані впливу КЗКК: криптографічні бібліотеки, протоколи мережевої безпеки, модернізацію обладнання та інфраструктуру відкритих ключів (PKI). Ця робота відповідає ширшій стратегії HPE у галузі постквантової криптографії, а також вимогам державних органів та галузі, що змінюються.
У сфері програмного забезпечення та криптографічних бібліотек продукти HPE Aruba розвиваються з метою впровадження стандартизованих NIST постквантових алгоритмів при збереженні криптогнучкості. Це дозволяє здійснювати розгортання, що забезпечують сумісність із наявними середовищами, та поступово додавати захист від квантових атак. Так, програмний продукт HPE ClearPass починаючи з останньої версії вже готовий до ПКК. Це дозволяє вже сьогодні використовувати нові криптографічні функції в HTTPS. Крім того, HPE ClearPass тепер повністю підтримує використання EAP-TLS із TLS версії 1.3, включаючи найновіші можливості, що випускаються разом із кінцевими пристроями (точками доступу).
Нещодавно поглинута компанією НРЕ компанія Juniper так само у своїй ОС Junos має підтримку ПКК. Образи ОС відповідають алгоритмам, рекомендованим Комерційним національним алгоритмом безпеки 2.0/CNSA 2.0: ML-DSA-87 для цифрових підписів та SHA-512 для хешування. Також ця ОС підтримує «квантовий буфер» у SSH, щоб покращити управління SSH та зберегти криптогнучкість, включаючи підтримку алгоритмів обміну ключами (NTRU Prime 761 у поєднанні з X25519), стійких до алгоритму Шора, за замовчуванням у SSH.

Майже кожна компанія, яка проходить шлях від перших тестових ресурсів до реального production-середовища в Azure, у певний момент стикається з однаковим питанням: чому рахунок за хмару зростає швидше, ніж очікували?
Важливо одразу зафіксувати головну думку: Azure стає дорогим не тому, що хмара сама по собі обов’язково дорога. Найчастіше витрати зростають тому, що середовищем не управляють системно. Немає зрозумілого tagging, бюджетів, власників ресурсів, правил вимкнення тестових середовищ, контролю за розміром віртуальних машин, reserved capacity або FinOps-процесу. У результаті бізнес платить не лише за корисне навантаження, а й за технічний хаос, який накопичився непомітно.
Цей матеріал буде корисний CFO, CIO, IT-директорам, керівникам інфраструктури, procurement-командам і власникам Azure-підписок. Особливо тим компаніям, які вже використовують Azure, але не мають впевненості, що оплачують саме потрібні сервіси, у правильному розмірі, з правильними політиками безпеки та зрозумілою відповідальністю.
У цій темі важливо не протиставляти економію та надійність. Для українського бізнесу Azure часто є частиною стратегії стійкості: резервні сервіси, віддалений доступ, disaster recovery, захист даних, швидке розгортання нових систем. Тому завдання не в тому, щоб будь-якою ціною зменшити рахунок. Завдання — зрозуміти, які витрати створюють цінність, а які є наслідком відсутності контролю.
1. Чому рахунки за Azure зростають непомітно
У наземній інфраструктурі вартість часто помітна заздалегідь: сервер потрібно купити, погодити, доставити, змонтувати, ввести в експлуатацію. У хмарі все інакше. Ресурс можна створити за кілька хвилин. Це головна перевага Azure, але водночас і джерело ризику. Якщо процес створення ресурсів швидкий, а процес контролю слабкий, витрати починають рости ще до того, як бізнес встигає це усвідомити.
Одна команда створює тестову віртуальну машину для пілота. Інша запускає базу даних для тимчасового проєкту. Хтось додає диски, snapshot, публічну IP-адресу або додатковий сервіс для інтеграції. Усе це може бути виправдано в момент створення. Але через кілька місяців частина ресурсів уже не використовується, власник змінив роль, проєкт завершився, а ресурси продовжують працювати й генерувати витрати.
Друга причина непомітного зростання витрат — відсутність прозорості. Якщо ресурси не промарковані тегами, фінансам складно зрозуміти, який департамент або проєкт споживає бюджет. Якщо немає бюджету на рівні subscription, resource group або бізнес-напряму, перевищення помічають уже постфактум. Якщо немає регулярного аналізу Cost Management, Azure Advisor і звітів для відповідальних осіб, то хмара перетворюється на “спільний гаманець”, де всі щось створюють, але ніхто не відповідає за загальну суму.
Третя причина — архітектурні рішення, які не переглядаються після запуску. На старті проєкту часто обирають ресурси “із запасом”, щоб уникнути проблем із продуктивністю. Це нормально для пілота або критичного запуску. Але якщо після стабілізації навантаження не провести right-sizing, компанія продовжить платити за надлишкову потужність. У Azure економія часто з’являється не від одного великого рішення, а від регулярної роботи з десятками таких дрібних оптимізацій.
2. Типові причини перевитрат у Azure

Найпоширеніший сценарій — forgotten resources. Це віртуальні машини, диски, IP-адреси, тестові середовища, storage accounts або сервіси, які колись були потрібні, але більше не використовуються. Окремо варто перевіряти orphaned disks — диски, які залишилися після видалення VM, але продовжують зберігатися й оплачуватися.
Друга причина — overprovisioning. Компанія використовує VM або бази даних більшого розміру, ніж потрібно фактичному навантаженню. Іноді це наслідок обережності, іноді — відсутності моніторингу CPU, RAM, IOPS і мережевого навантаження. Без регулярного перегляду такі ресурси роками працюють у завищеній конфігурації.
Третя зона — неправильні VM SKU. Для різних навантажень потрібні різні типи інстансів: загального призначення, memory optimized, compute optimized тощо. Якщо SKU обрано без аналізу профілю навантаження, компанія може переплачувати або, навпаки, отримувати проблеми з продуктивністю.
Четверта причина — snapshots, backups і retention без контролю. Резервні копії потрібні, але вони мають відповідати реальним вимогам RPO/RTO, політикам зберігання й критичності сервісів. Якщо snapshots накопичуються без строку життя, а backup-політики створюються “про всяк випадок”, витрати на зберігання можуть зростати непомітно.
П’ята зона — трафік і архітектура передачі даних. Надмірний egress, дублювання даних між регіонами, неоптимальні інтеграції або неправильне розміщення сервісів можуть створювати додаткові витрати. Часто це не видно в момент проєктування, але стає помітно у щомісячному рахунку.
Шоста причина — відсутність reserved capacity, reservations або savings plans для стабільних навантажень. Якщо workload працює постійно й прогнозовано, оплата лише за pay-as-you-go може бути не найефективнішою моделлю. Але купувати зобов’язання без аналізу також ризиковано: спочатку потрібно зрозуміти реальне використання, сезонність, плани розвитку та можливі зміни архітектури.
3. Що таке FinOps для Azure простими словами

FinOps — це не лише завдання фінансового відділу і не лише технічна оптимізація. Це операційна модель, у якій IT, фінанси, закупівлі та бізнес-власники разом управляють хмарними витратами. Мета FinOps — не просто “урізати рахунок”, а зробити витрати зрозумілими, керованими й прив’язаними до бізнес-цінності.
Для Azure це означає, що кожен ресурс має власника, призначення, бюджет, теги, правила життєвого циклу та зрозуміле місце в архітектурі. Компанія має знати не тільки скільки коштує Azure, а й чому саме стільки, хто споживає бюджет, які ресурси створюють цінність, а які є технічним боргом.
Простий FinOps-процес можна описати чотирма кроками: Visibility, Optimization, Governance, Continuous Control. Спочатку потрібно побачити витрати: Cost Analysis, budgets, теги, власники, alerts, звіти. Потім — оптимізувати: right-sizing, shutdown schedules, storage tiers, reservations, savings plans, видалення зайвих ресурсів. Далі — закріпити правила: Azure Policy, naming convention, tagging standard, approval process, landing zone, security guardrails. І після цього — підтримувати регулярний контроль: щомісячні перегляди, KPI, звіти, roadmap оптимізації та відповідальні власники.
У зрілій моделі FinOps економія не повинна шкодити продуктивності або безпеці. Немає сенсу вимкнути резервне копіювання лише для того, щоб зменшити рахунок. Немає сенсу зменшити VM до рівня, де бізнес-система почне працювати нестабільно. Правильна оптимізація — це баланс між вартістю, продуктивністю, безпекою та вимогами бізнесу.
4. Як провести Azure Cost & Risk Assessment
Azure Cost & Risk Assessment варто починати з інвентаризації. Потрібно зібрати поточні subscriptions, resource groups, основні сервіси, власників, регіони, мережеві зв’язки, критичні workloads, політики backup і monitoring. Без цього неможливо зрозуміти, що саме оптимізувати.
Другий крок — аналіз витрат. Потрібно подивитися структуру рахунку: які сервіси формують найбільшу частину витрат, які витрати зростають найшвидше, які ресурси не мають тегів, які департаменти або проєкти неможливо коректно віднести до бюджету. На цьому етапі важливо працювати не лише з загальною сумою, а й із деталізацією по ресурсах, групах, типах сервісів і періодах.
Третій крок — технічна оцінка ресурсів. Перевіряються віртуальні машини, диски, snapshots, storage, бази даних, мережа, backup, monitoring, публічні IP, невикористані ресурси й рекомендації Azure Advisor. Окремо варто оцінити, які workloads є постійними, а які тимчасовими, де можна застосувати reserved capacity або savings plans, а де краще залишити гнучку модель оплати.
Четвертий крок — оцінка ризиків. Оптимізація вартості не може бути відірвана від безпеки та стійкості. Якщо ресурс виглядає дорогим, це ще не означає, що його можна просто вимкнути. Потрібно розуміти, чи є залежності, які сервіси використовують цей ресурс, чи є backup, які наслідки для бізнесу, який RTO/RPO, хто власник рішення і чи можна змінювати архітектуру без простою.
П’ятий крок — roadmap. Результатом assessment має бути не абстрактний звіт, а перелік пріоритетних дій: що можна зробити швидко, що потребує погодження, що дасть економію, що зменшить ризики, які зміни потребують PoC, які правила governance потрібно впровадити на майбутнє.
5. Як LANTEC допомагає
У LANTEC ми дивимося на Azure не лише як на набір сервісів, а як на кероване бізнес-середовище. Наш підхід починається з discovery: ми збираємо інформацію про поточне використання Azure, бізнес-критичні сервіси, архітектурні обмеження, вимоги до безпеки, доступність, резервне копіювання та фінансову модель.
Далі проводимо аудит витрат і ризиків: аналізуємо subscriptions, resource groups, теги, власників, VM, диски, snapshots, storage, мережу, backup, monitoring, Azure Advisor recommendations, потенціал reserved capacity або savings plans. Ми не пропонуємо просто “вимкнути зайве”. Ми перевіряємо залежності, вплив на бізнес і можливі ризики для продуктивності та безпеки.
Після аудиту формуємо архітектурні рекомендації: які ресурси оптимізувати, де потрібен right-sizing, які середовища можна переводити на графік роботи, де доцільні reserved instances або savings plans, які політики tagging і budgets потрібно впровадити, як побудувати governance, щоб проблема не повторювалася через кілька місяців.
Окремий блок — регулярний контроль. Azure змінюється разом із бізнесом: з’являються нові проєкти, нові сервіси, нові команди, нові ризики. Тому оптимізація не повинна бути одноразовою акцією. Вона має стати процесом: періодичний перегляд витрат, відповідальні власники, звіти для IT і фінансів, контроль бюджетів, alerting і roadmap розвитку.
Azure не має бути дорогим. Але Azure має бути керованим. Витрати в хмарі стають проблемою тоді, коли ресурси створюються швидше, ніж компанія встигає їх контролювати. Без tagging, budgets, ownership, архітектурного перегляду та FinOps-процесу хмара поступово накопичує технічний і фінансовий борг.
Зріла модель управління Azure починається з прозорості. Потрібно бачити, хто споживає ресурси, за що платить компанія, які сервіси критичні, які можна оптимізувати, а які створюють ризики. Лише після цього варто приймати рішення про right-sizing, reserved capacity, savings plans, зміну архітектури або правила governance.
Фахівці LanTec допоможуть зрозуміти, де можна зменшити витрати без втрати продуктивності та безпеки, підготувати пріоритетний план оптимізації та побудувати регулярний контроль хмарного середовища.
Авторка статті — Олена Друм, Cloud Product Manager, LANTEC

